Los 7 mejores servidores GPU para IA y aprendizaje automático en 2026

Si existe alguna máquina capaz de manejar grandes cantidades de datos para entrenar modelos de IA y aprendizaje automático, es un servidor GPU. ¿Por qué configurar el mejor servidor GPU para IA y aprendizaje automático? ¿No podemos usar un servidor dedicado normal? ¡La respuesta es no!
El funcionamiento del modelo de IA y ML es complejo.
Permite que las computadoras aprendan de los datos que recopilan, tomen decisiones e incluso mejoren con el tiempo sin necesidad de volver a programarlas. Ayuda a los médicos a diagnosticar con mayor rapidez, permite que asistentes de voz como Alexa o Jarvis nos comprendan y respondan, e incluso nos sugiere qué series de Netflix nos gustaría ver.
Como ves, la IA resuelve todos nuestros problemas de una forma más inteligente. Por eso, entrenar modelos de IA y aprendizaje automático requiere enormes cantidades de datos y cálculos extremadamente complejos, y hacerlo en un servidor normal puede ser complicado (lento y con retrasos).
Aquí es donde los servidores GPU resultan útiles. Ofrecen la velocidad, la potencia de procesamiento y la eficiencia necesarias para gestionar el aprendizaje profundo, el reconocimiento de imágenes, el procesamiento del lenguaje natural y otras tareas complejas de IA con mayor fluidez.
Aquí analizaremos los 7 mejores proveedores de servidores GPU para IA y aprendizaje automático. Para facilitarte aún más las cosas, también hemos añadido información detallada sobre cada proveedor para que puedas entender claramente cómo funciona todo sin necesidad de conocimientos técnicos.
Por el final de la blogTendrás una buena idea de qué servidor GPU podría ser el más adecuado para tus proyectos de IA y aprendizaje automático.

¿Qué es un servidor GPU para IA y aprendizaje automático?
Un servidor GPU es un sistema informático de alto rendimiento diseñado con potentes unidades de procesamiento de gráficos para manejar las pesadas cargas de trabajo requeridas en IA y aprendizaje automático (ML).
Ofrece un alto ancho de banda de memoria, transferencia de datos más rápida y hardware especializado para optimizar los cálculos. La GPU incluye especificaciones como memoria de gran capacidad (hasta cientos de GB), conexión de alta velocidad y arquitecturas optimizadas para redes neuronales.
Por eso es fácil entrenar modelos de IA como ChatGPT, sistemas de visión artificial y sistemas de conducción autónoma sin que se bloqueen. En resumen, un El servidor GPU proporciona La potencia y la escalabilidad extrema necesarias para entrenar y gestionar el flujo de trabajo de IA y ML sin problemas.
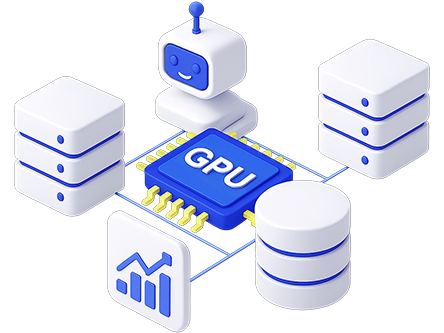
¿Por qué no podemos usar una CPU para IA/ML? ¿Por qué una GPU? ¿Cuál es la diferencia entre una CPU normal y una GPU? Una CPU procesa las tareas una por una, mientras que una GPU (construida con miles de núcleos más pequeños) puede realizar múltiples cálculos y ejecutar varias tareas simultáneamente.
Los 7 mejores servidores GPU para IA y aprendizaje automático en 2026
Ahora, no perdamos ni un minuto y pasemos a los 7 mejores servidores GPU para IA y ML en 2026. Aquí, enumeraremos solo los servidores GPU más confiables y con rendimiento probado, elegidos después de una verificación exhaustiva para garantizar que satisfagan las necesidades de las cargas de trabajo modernas de IA y aprendizaje profundo.
Todos los proveedores mencionados están 100% probados y son confiables, por lo que puede confiar en ellos para entrenar modelos de IA grandes..
⏰ TL;DR:
1. Interserver – El mejor servidor GPU en general para IA y aprendizaje automático
2. Liquidweb – El mejor servidor GPU para IA y aprendizaje automático
3. Digital Ocean – Servidores GPU escalables para IA y aprendizaje automático
4. Vultr – Servidores GPU asequibles para IA y aprendizaje automático
5. Nube E2E – Los principales servidores GPU de la India para IA y aprendizaje automático
6. Amazon Web Services – Servidores GPU de nivel empresarial para la innovación en IA
7. Google Cloud Platform – Servidores GPU de alto rendimiento para IA y aprendizaje automático
1. InterServer – El mejor servidor GPU en general para IA y aprendizaje automático
A partir de InterServer Los servidores dedicados a GPU están diseñados para ofrecer el máximo rendimiento, proporcionando la potencia bruta necesaria para el entrenamiento de IA, el aprendizaje automático y el procesamiento de datos complejos.
InterServer
Ventajas
- InterServer Ofrece un rendimiento confiable y tiempo de actividad.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
A partir de InterServer Los servidores dedicados a GPU están diseñados para ofrecer el máximo rendimiento, proporcionando la potencia bruta necesaria para el entrenamiento de IA, el aprendizaje automático y el procesamiento de datos complejos.
Precio: USD 275/mes
Visitar InterServerEquipados con las últimas GPU NVIDIA y procesadores AMD Ryzen, estos servidores garantizan computación paralela, un entrenamiento de modelos más rápido y un rendimiento acelerado. Fabricados en centros de datos de primera clase, ofrecen una infraestructura de alta calidad con alimentación, refrigeración y redes redundantes para garantizar la fiabilidad bajo cargas de trabajo intensas.
Con configuraciones personalizables, implementación rápida, InterServer Los servidores GPU brindan a los desarrolladores la escalabilidad y la eficiencia necesarias para manejar tareas exigentes de IA y ML.
Características principales
- Potente aceleración de GPU: Ofrece GPU NVIDIA de vanguardia, como las RTX 4080 y RTX A5000. Ofrece un rendimiento inigualable para el entrenamiento de modelos de aprendizaje profundo. Esto garantiza un cálculo más rápido y tiempos de entrenamiento más cortos.
- Infraestructura escalable: Cada servidor puede tener hasta 4 GPU, lo que facilita la escalabilidad de recursos a medida que crecen los proyectos. Esta flexibilidad permite a empresas e investigadores gestionar cargas de trabajo de IA cada vez más complejas sin comprometer el rendimiento.
- Almacenamiento y red de alto rendimiento: Con almacenamiento NVMe (hasta 4 TB) y puertos de red dedicados de 1 Gbps, estos servidores garantizan un acceso a datos de alta velocidad y la transferencia ininterrumpida de grandes conjuntos de datos. Esto es fundamental para el entrenamiento de sistemas de IA que requieren un gran volumen de trabajo de entrada y salida.
- Seguridad y confiabilidad avanzadas: Todos los servidores incluyen protección contra ataques DDoS, suministro de energía redundante y monitoreo completo del servidor para garantizar el tiempo de actividad y proteger las cargas de trabajo. Esto los hace ideales para aplicaciones críticas de IA y ML.
- Configuraciones personalizadas para IA y ML: Más allá de las GPU estándar, InterServer Ofrece configuraciones personalizadas con GPU GeForce para satisfacer necesidades computacionales específicas. Esta flexibilidad garantiza que los usuarios obtengan el equilibrio perfecto entre rendimiento y costo para sus proyectos de IA.
Precios
| $275 al mes (AMD RYZEN 5900X) | $310 al mes (AMD RYZEN 9950X) |
| RAM 64GB | RAM 96GB |
| 2 NVMe de 2 TB | 2 NVMe de 4 TB |
2. LiquidWeb – El mejor servidor GPU para IA y aprendizaje automático
Hablemos de los servidores GPU Liquid Web, diseñados para optimizar las cargas de trabajo de IA, ML y HPC con alta velocidad. Con servidores GPU totalmente dedicados y de un solo inquilino, los usuarios obtienen el 100 % de los recursos computacionales disponibles, garantizando así la máxima eficiencia al compartir GPU.
LiquidWeb

Ventajas
- LiquidWeb ofrece un rendimiento y un tiempo de actividad confiables.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
Hablemos de los servidores GPU Liquid Web, diseñados para optimizar las cargas de trabajo de IA, ML y HPC con alta velocidad. Con servidores GPU totalmente dedicados y de un solo inquilino, los usuarios obtienen el 100 % de los recursos computacionales disponibles, garantizando así la máxima eficiencia al compartir GPU.
Estos servidores funcionan con GPU NVIDIA de primera línea y CPU AMD EPYC de alto rendimiento, lo que permite un entrenamiento ultrarrápido incluso para los modelos más complejos, como tareas de visión artificial y aprendizaje profundo.
Los servidores eliminan la sobrecarga de la virtualización, ofreciendo una potencia de cálculo ininterrumpida optimizada para el procesamiento paralelo intensivo. Su infraestructura está diseñada para gestionar grandes volúmenes de trabajo sin problemas, con almacenamiento SSD de alta capacidad, redes de alto ancho de banda y protección DDoS avanzada. Esta combinación permite a las organizaciones entrenar modelos complejos rápidamente y gestionar cargas de trabajo intensivas sin inconvenientes.
Características principales
- Recursos dedicados para un solo inquilino: Proporciona servidores totalmente dedicados, lo que garantiza la ausencia de interferencias de entornos compartidos. Esto garantiza una potencia de procesamiento constante y el cumplimiento de estándares estrictos como el RGPD y la HIPAA, ideal para cargas de trabajo de IA seguras.
- GPU NVIDIA de nivel empresarial: Equipados con las GPU NVIDIA más recientes, estos servidores ofrecen capacidades de procesamiento paralelo. Estos servidores de nivel empresarial están diseñados específicamente para cargas de trabajo de aprendizaje automático y aprendizaje automático (ML/DL), lo que optimiza los tiempos de entrenamiento y la fiabilidad.
- CPU de alto rendimiento con sinergia de GPU: Los procesadores duales AMD EPYC con hasta 96 núcleos gestionan las tareas computacionales mientras trabajan junto con las GPU para operaciones con uso intensivo de datos. Esta sinergia CPU-GPU garantiza la ejecución fluida de los procesos de IA.
- Infraestructura escalable y flexible: Ofrece configuraciones de servidor personalizables, lo que facilita la ampliación de la potencia de procesamiento a medida que aumentan las cargas de trabajo. Ya sean tareas de inferencia ligeras o trabajos de entrenamiento masivos, la infraestructura se adapta a la perfección sin afectar la velocidad.
- Implementación rápida y herramientas de IA listas para usar: Los servidores se configuran en tan solo 15 minutos, con frameworks preinstalados como TensorFlow. Esto permite a los científicos de datos y desarrolladores omitir la configuración y comenzar de inmediato a experimentar, entrenar e implementar modelos de IA.
Precios
| $0.95 por hora (NVIDIA L4 Ada 24 GB) | $1.70 por hora (NVIDIA L40S Ada 48GB) |
| 128 GB de RAM DDR5 | 256 GB de RAM DDR5 |
| RAID-1.92 NVMe de 1 TB | RAID-3.84 NVMe de 1 TB |
3. Digital Ocean – Servidores GPU escalables para IA y aprendizaje automático
A continuación, contamos con los servidores GPU de DigitalOcean, que ofrecen una solución escalable para cargas de trabajo de IA/ML, aprendizaje profundo, análisis y computación de alto rendimiento. Con solo dos clics, puede ejecutar una gota de GPU completa en menos de dos minutos, lo que brinda a los equipos acceso inmediato a potentes recursos informáticos sin problemas de infraestructura.
Digital Ocean

Ventajas
- DigitalOcean ofrece un rendimiento y un tiempo de actividad confiables.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
A continuación, contamos con los servidores GPU de DigitalOcean, que ofrecen una solución escalable para cargas de trabajo de IA/ML, aprendizaje profundo, análisis y computación de alto rendimiento. Con solo dos clics, puede ejecutar una gota de GPU completa en menos de dos minutos, lo que brinda a los equipos acceso inmediato a potentes recursos informáticos sin necesidad de infraestructura.
Estos servidores están diseñados para ofrecer flexibilidad, respaldados por productos compatibles con HIPAA y SOC 2, con acuerdos de nivel de servicio (SLA) de primera calidad. Con el respaldo de potentes opciones de GPU de NVIDIA y AMD, los servidores DigitalOcean pueden gestionar todo tipo de tareas, como el entrenamiento de modelos de gran tamaño, el ajuste preciso para una inferencia rápida y la computación de alto rendimiento.
Gracias a su gran capacidad de memoria GPU, ancho de banda y almacenamiento NVMe local robusto, ofrecen un buen rendimiento para tareas como el entrenamiento de modelos LLM, IA generativa y cargas de trabajo HPC con uso intensivo de datos.
Características principales
- Configuración ultrarrápida: Ejecute una gota de GPU en menos de 2 minutos con una interfaz sencilla e intuitiva. Esto elimina los problemas de infraestructura y permite a su equipo ejecutar cargas de trabajo de IA al instante.
- Arquitectura escalable y flexible: Escala fácilmente con clústeres de una o varias GPU (hasta 8 GPU) para gestionar modelos con miles de millones de parámetros. Se adapta a la perfección a proyectos de cualquier tamaño.
- Confiabilidad de nivel empresarial: Con el respaldo de acuerdos de nivel de servicio (SLA) empresariales, cumplimiento de HIPAA y certificación SOC 2, DigitalOcean garantiza un tiempo de actividad seguro y garantizado. Los equipos pueden centrarse en las cargas de trabajo de IA sin preocuparse por el tiempo de inactividad.
- Rendimiento rentable: Obtendrás hasta un 75 % más de descuento que los hiperescaladores para GPU bajo demanda como las H100 y las H200. Esto hace que las cargas de trabajo avanzadas de IA y ML sean asequibles tanto para startups como para grandes empresas.
- Potentes opciones de GPU: Elija entre NVIDIA H100, H200 o AMD MI325X y MI300X, optimizadas para todo, desde entrenamiento LLM hasta inferencia de alto rendimiento. La variedad garantiza la solución ideal para cada carga de trabajo.
Precios
| $3.44 por hora (NVIDIA H200) | $3.99 por hora (NVIDIA H100) |
| RAM 240GB | RAM de GPU de 80 GB |
| Almacenamiento NVMe de 720 GB | Almacenamiento NVMe de 720 GB |
4. Vultr Servidores GPU asequibles para IA y aprendizaje automático
¿Qué ofrece Vult de especial? Los servidores GPU de Vultr Cloud ofrecen acceso bajo demanda a las GPU AMD y NVIDIA más recientes para IA/ML, RA/RV, computación de alto rendimiento (HPC) y más.
Vultr
Ventajas
- Vultr ofrece rendimiento y tiempo de actividad confiables.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
¿Qué ofrece Vult de especial? Los servidores GPU de Vultr Cloud ofrecen acceso bajo demanda a las GPU AMD y NVIDIA más recientes para IA/ML, RA/RV, computación de alto rendimiento (HPC) y más.
Está respaldado por aceleradores AMD Instinct de última generación y computación acelerada NVIDIA. Vultr garantiza un alto rendimiento y escalabilidad incluso para las cargas de trabajo más exigentes. Esto lo convierte en una potente solución para investigadores y empresas que buscan acelerar la innovación.
Con Vultr Kubernetes Engine para GPU en la Nube, los desarrolladores pueden crear sistemas acelerados por GPU para gestionar cargas de trabajo de IA y ML que consumen muchos recursos a nivel mundial. Esta infraestructura integrada permite a los innovadores implementar modelos avanzados de forma eficiente.
Características principales
- Últimas GPU AMD y NVIDIA: Proporciona acceso a GPU como NVIDIA H100 y AMD, lo que proporciona potencia para cargas de trabajo de IA/ML y HPC. Estas GPU están optimizadas para el entrenamiento de modelos de IA a gran escala, simulaciones científicas y cargas de trabajo gráficas de última generación.
- Clústeres de Kubernetes acelerados por GPU: Con Vultr Kubernetes Engine, las empresas pueden crear y escalar clústeres con tecnología GPU en cualquier parte del mundo. Esto facilita la gestión de tareas de IA/ML que consumen muchos recursos, el análisis de datos y los procesos de entrenamiento a gran escala.
- Infraestructura de nube global: Opera en 32 regiones de centros de datos y ofrece capacidades de implementación verdaderamente globales. Esto garantiza un rendimiento de baja latencia para las aplicaciones y accesibilidad para equipos distribuidos.
- Inferencia sin servidor para GenAI: Se trata de una plataforma de inferencia sin servidor que permite el despliegue rápido de modelos de IA generativa sin la complejidad de una infraestructura compleja. Los usuarios pueden escalar las cargas de trabajo bajo demanda e integrar datos propios en el modelo.
- GPU en la nube flexible y rentable: Las GPU en la nube pueden implementarse como sistemas dedicados o máquinas virtuales bajo demanda, lo que ofrece a los usuarios control total. El modelo de precios está diseñado para ser significativamente más asequible en comparación con los hiperescaladores.
Precios
| $3.99 por hora (AMD MI300X) | $2.89 por hora (NVIDIA HGX B200) |
| RAM de GPU de 1536 GB | RAM de GPU de 1536 GB |
| Almacenamiento NVMe de 13 TB | Almacenamiento NVMe de 13 TB |
5. Nube E2E – Los principales servidores GPU de la India para IA y aprendizaje automático
A continuación, tenemos E2E Servidores GPU en la nube Diseñados específicamente para ejecutar cargas de trabajo de IA, ML y HPC a gran escala con la máxima eficiencia y flexibilidad. Con el respaldo de las GPU NVIDIA más recientes, como H200, H100, A100 y más, estos servidores ofrecen un ancho de banda de memoria ultrarrápido, procesamiento paralelo y computación de alto rendimiento para acelerar el entrenamiento de modelos complejos.
Nube E2E
Ventajas
- E2E Cloud ofrece rendimiento y tiempo de actividad confiables.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
A continuación, contamos con servidores GPU en la nube E2E, diseñados específicamente para ejecutar cargas de trabajo de IA, ML y HPC a gran escala con la máxima eficiencia y flexibilidad. Con el respaldo de las GPU NVIDIA más recientes, como H200, H100, A100 y más, estos servidores ofrecen un ancho de banda de memoria ultrarrápido, procesamiento paralelo y alta velocidad.
Con escalabilidad bajo demanda y precios de pago por uso, los usuarios pueden alquilar exactamente los recursos de GPU que necesitan. Pueden entrenar redes neuronales profundas y potenciar modelos de lenguaje extensos para realizar simulaciones y renderizado de alta gama.
Los servidores GPU E2E ofrecen un rendimiento consistente para las cargas de trabajo más exigentes. Su infraestructura en la nube garantiza una distribución fluida de la carga de trabajo y un uso optimizado de los recursos, lo que los convierte en la opción ideal para startups que trabajan en innovaciones de IA de última generación.
Características principales
- Amplia cartera de GPU: Ofrece acceso a GPU líderes en la industria, como NVIDIA H200, H100, A100 y más. Esta variedad le garantiza elegir la GPU exacta que mejor se adapte a su carga de trabajo, desde el entrenamiento de modelos de IA a gran escala hasta la inferencia rentable.
- Memoria de alta velocidad y ancho de banda: Con hasta 80 GB de memoria HBM2e y el ancho de banda más rápido del mundo en GPU como la A100, las tareas con uso intensivo de datos se ejecutan con fluidez. Esto permite ciclos de entrenamiento más rápidos y una mayor eficiencia en el manejo de conjuntos de datos masivos.
- Precios flexibles y escalabilidad: Con las opciones de alquiler por hora, solo paga por la potencia de la GPU que utiliza. Supongamos que necesita una sola GPU para pruebas o un clúster Deep64 de 64 GPU. El E2E le permite escalar recursos dinámicamente según las necesidades del proyecto.
- Optimizado para cargas de trabajo de IA y ML: Diseñados exclusivamente para aprendizaje profundo, modelos de lenguaje de gran tamaño y aplicaciones HPC, los servidores GPU aceleran el entrenamiento y la inferencia de modelos. La compatibilidad integrada con frameworks como TensorFlow y PyTorch garantiza la compatibilidad.
- Infraestructura de nube de nivel empresarial: Con conectividad InfiniBand, almacenamiento basado en SSD y funciones de nube avanzadas como escalamiento automático, firewalls y equilibrio de carga, E2E garantiza entornos seguros, estables y de alto rendimiento para cargas de trabajo críticas de IA/ML.
Precios
| $5.38 por hora (NVIDIA H200) | $36.10 por hora (GDC HGX-100) |
| RAM 375GB | RAM 1800GB |
| Almacenamiento NVMe de 2 TB | Almacenamiento NVMe de 21 TB |
6. Amazon Web Services Servidores GPU de nivel empresarial para la innovación en IA
Los servidores GPU de AWS, con GPU NVIDIA de vanguardia integradas, están diseñados para gestionar algunas de las cargas de trabajo de IA y aprendizaje automático más exigentes. Con IA generativa, modelos de lenguaje de gran tamaño, computación de alto rendimiento y análisis en tiempo real, AWS proporciona la flexibilidad y la escalabilidad que necesitan las empresas modernas.
Con instancias optimizadas para GPU como Amazon EC2 P5 (NVIDIA H100) y P6e UltraServers (GPU Blackwell), AWS permite un entrenamiento más rápido y una implementación fluida de modelos de IA complejos. Para los principiantes, AWS también ofrece una prueba gratuita con NVIDIA, lo que facilita la experimentación y el aprendizaje sin incurrir en costos.
Además de entrenar modelos de IA, los servidores GPU de AWS son igualmente efectivos para simulaciones de HPC, estaciones de trabajo virtuales, implementaciones de borde de IoT y casos de uso de metaverso industrial.
Características principales
- Rendimiento de GPU de próxima generación con NVIDIA: Combina las GPU NVIDIA más recientes, como los núcleos Tensor H100 y la arquitectura Grace Blackwell, lo que permite una alta potencia computacional. Estas GPU están optimizadas para el entrenamiento de aprendizaje profundo y las cargas de trabajo de IA generativa, lo que ayuda a las empresas a lograr buenos resultados.
- Cargas de trabajo escalables de HPC e IA: Las instancias de GPU permiten a los clientes ejecutar simulaciones a gran escala, genómica, análisis sísmico y entrenamiento de modelos de IA con una escalabilidad prácticamente ilimitada. Esta flexibilidad ayuda a las organizaciones a superar las limitaciones de los entornos y a obtener resultados con mayor rapidez.
- Integración perfecta del borde a la nube: Con servicios como AWS IoT Greengrass y los módulos de NVIDIA, las cargas de trabajo pueden ejecutarse eficientemente en el borde, a la vez que se conectan a la nube para análisis y almacenamiento. Esto garantiza una toma de decisiones de baja latencia para IoT y robótica.
- Estaciones de trabajo virtuales con tecnología RTX: Los servidores GPU se pueden utilizar para implementar estaciones de trabajo creativas remotas que ofrecen un rendimiento de nivel de estudio para diseño 3D, edición de video y creación de contenido asistida por IA.
- Preparada para IA generativa con NVIDIA AI Enterprise: Marketplace de AWS ofrece software NVIDIA AI Enterprise, incluidos microservicios NeMo y NIM, que simplifican la adopción de IA generativa.
Precios
Comuníquese con el equipo de ventas (AWS ofrece planes personalizados)
7. Google Cloud Platform Servidores GPU de alto rendimiento para IA y aprendizaje automático
Ahora, contamos con servidores GPU de Google Cloud que ofrecen una gran capacidad de procesamiento para IA, aprendizaje automático, investigación científica y cargas de trabajo de IA generativa. Con una amplia selección de GPU, incluyendo NVIDIA GB200, H200 y H100, puede elegir el equilibrio ideal entre costo y rendimiento para acelerar el entrenamiento, la inferencia y la visualización 3D.
Google Cloud Platform
Ventajas
- Google Cloud Platform ofrece un rendimiento y un tiempo de actividad confiables.
- Fácil de comenzar con una interfaz intuitiva.
- Equipo de atención al cliente receptivo.
- Precios competitivos para las prestaciones ofrecidas.
Desventajas
- Opciones de personalización avanzadas limitadas.
- Podría mejorar la documentación y los tutoriales.
Resumen
Ahora contamos con servidores GPU de Google Cloud que ofrecen potencia informática de alto rendimiento para IA, aprendizaje automático, investigación científica y cargas de trabajo de IA generativa. Con una amplia selección de GPU, como NVIDIA GB200, H200 y H100, puedes encontrar el equilibrio perfecto entre coste y rendimiento para acelerar la formación.
Las configuraciones flexibles de las máquinas permiten combinar hasta 8 GPU simultáneamente con CPU, memoria y almacenamiento optimizados, lo que garantiza la escalabilidad. Los nuevos usuarios también pueden aprovechar los créditos de prueba gratuitos de Google Cloud, que les permiten explorar cargas de trabajo basadas en GPU sin costo inicial.
Esto te permite probar instancias de GPU, entrenar modelos de aprendizaje profundo y experimentar con soluciones de IA generativa sin riesgo financiero. Combinado con la facturación por segundo y la capacidad de escalar según demanda, Google Cloud facilita la creación, prueba e implementación eficiente de cargas de trabajo avanzadas de GPU.
Características principales
- Amplia cartera de GPU: Desde la NVIDIA T4 básica hasta los aceleradores GB200 y H100 de vanguardia, Google Cloud ofrece una amplia gama de tipos de GPU. Esta flexibilidad garantiza soluciones rentables para todo, desde aprendizaje automático sencillo hasta entrenamiento de HPC e IA a gran escala.
- Escalamiento flexible del rendimiento: Puede conectar hasta 8 GPU por instancia y combinarlas con vCPU, RAM y almacenamiento personalizados. Este diseño modular le permite crear el entorno ideal para su carga de trabajo, evitando costos innecesarios.
- Infraestructura líder en la industria: También se beneficia de su red global de baja latencia, potentes soluciones de almacenamiento y herramientas avanzadas de análisis de datos. Esto crea un ecosistema donde las cargas de trabajo de IA pueden ejecutarse con mayor rapidez, seguridad y fiabilidad.
- Precios de pago por uso: Con la facturación por segundo y los precios regionales de GPU, solo pagas por los recursos exactos que utilizas. Esto es especialmente útil para experimentos de IA, ciclos de entrenamiento o cargas de trabajo temporales, donde la rentabilidad es fundamental.
- Integración perfecta con herramientas de IA: Las GPU de Google Cloud se integran a la perfección con Vertex AI, Kubernetes Engine y Dataflow. Esto facilita la aceleración de pipelines de aprendizaje automático, el entrenamiento de modelos o la implementación de soluciones de IA generativa mediante marcos integrados y los servicios administrados de Google.
Precios
| $0.35 por hora (NVIDIA T4) | $0.60 por hora (NVIDIA P4) |
| 13GB GDDR6 | 32GB GDDR6 |
| Almacenamiento NVMe de 1 TB | Almacenamiento NVMe de 2 TB |
¿Por qué elegir GPU Server para IA y aprendizaje profundo?
¡Dejemos algo claro! Si bien una persona normal... servidor dedicado Puede gestionar tareas básicas, pero presenta dificultades ante las altas exigencias de la IA y el aprendizaje profundo. ¡Por eso se utilizan servidores GPU! Ofrecen potencia y eficiencia para gestionar grandes cargas de trabajo con precisión. Estas son las principales razones por las que se necesita un servidor GPU:
Para potencia de procesamiento paralelo
Las GPU gestionan miles de tareas simultáneamente. Esta es una característica importante para el entrenamiento de modelos de aprendizaje profundo, donde se realizan millones de cálculos a la vez. Como resultado, el tiempo de entrenamiento se reduce drásticamente.
Para un entrenamiento y una inferencia más rápidos
Los modelos de IA y aprendizaje profundo requieren una gran cantidad de datos de entrenamiento para lograr precisión. Los servidores GPU optimizan este proceso al ofrecer mayor potencia computacional. Esto se traduce en resultados más rápidos y una implementación más ágil de las aplicaciones de IA.
Para optimizar datos a gran escala
El aprendizaje profundo requiere conjuntos de datos masivos, desde imágenes hasta texto y vídeos. Las GPU están diseñadas con un alto ancho de banda de memoria, lo que garantiza el procesamiento eficiente de grandes volúmenes de datos. Esto permite un entrenamiento más fluido y sin problemas.
Para respaldar los marcos de IA modernos
La mayoría de los frameworks de IA, como TensorFlow y CUDA, están optimizados para la aceleración por GPU. Esto permite a los desarrolladores aprovechar al máximo la potencia de la GPU sin configuraciones complejas. Garantiza una escalabilidad y seguridad extremas en los proyectos de IA.
Factores a considerar al elegir una GPU para aprendizaje profundo
Especialmente para los principiantes, elegir la GPU adecuada para aprendizaje profundo puede resultar confuso con tantos modelos, especificaciones y opciones disponibles. Por eso, hemos recopilado los 5 aspectos principales que debes considerar antes de comprar un servidor GPU:
Memoria GPU (VRAM)
El tamaño de la memoria de la GPU determina el tamaño del conjunto de datos o modelo de IA que se puede entrenar simultáneamente. Una mayor memoria permite gestionar tamaños mayores y redes más profundas. Para la IA moderna, se recomiendan al menos 24 GB para modelos complejos.
Rendimiento de cómputo (TFLOPS)
La potencia computacional bruta depende directamente de la velocidad de entrenamiento de su modelo. Las GPU con mayor TFLOPS (es decir, billones de operaciones por segundo) ofrecen resultados más rápidos. Compare siempre el rendimiento antes de comprar.
Factor de forma (PCIe vs. SXM)
Las GPU vienen en diferentes formatos que influyen en la velocidad y la escalabilidad. Las tarjetas PCIe son más fáciles de configurar, mientras que los módulos SXM ofrecen mayor ancho de banda y mejor rendimiento para modelos de IA a gran escala. Elija según el tamaño de su proyecto.
Eficiencia energética y refrigeración
El entrenamiento de IA puede durar horas o incluso días, generando grandes cantidades de calor. Las GPU eficientes consumen menos energía y funcionan bien con los sistemas de refrigeración de servidores. Esto reduce los costes de aire acondicionado a largo plazo.
Compatibilidad del ecosistema y el marco
Asegúrate de que la GPU que elijas sea compatible con frameworks y bibliotecas populares como CUDA, TensorFlow y PyTorch. Esto garantiza una integración perfecta y maximiza la rentabilidad de tu inversión en un servidor GPU.
FAQ’s
¿Cuáles son las mejores GPU para servidores de IA/ML en 2026?
InterServer Ofrece el mejor servidor GPU para IA/aprendizaje automático. Incluye las GPU H100, H200 y la novedosa B200 de Blackwell, opciones muy populares para cargas de trabajo de IA/aprendizaje automático. Está diseñado para el entrenamiento de alto rendimiento de grandes modelos de lenguaje (LLM), IA generativa, visión artificial y computación científica.
SXM vs PCIe: ¿qué factor de forma es mejor para los servidores de IA?
¡Todo depende de tu carga de trabajo y presupuesto! SXM se conecta directamente a la placa base del servidor, lo que ofrece mayores límites de potencia, mayor ancho de banda de memoria y compatibilidad con NVLink para escalado multiGPU. Esto hace que SXM sea perfecto para capacitaciones a gran escala donde la eficiencia y la velocidad son cruciales. Por otro lado, PCIe es más asequible, extremadamente compatible con diferentes tipos de servidores y más fácil de conseguir. Son ideales para capacitaciones a pequeña escala y organizaciones que buscan flexibilidad para actualizar el hardware.
H100 vs H200 vs B200: ¿cómo elijo?
Para las empresas que necesitan alto rendimiento a bajo coste, el H100 es la mejor opción. Es ideal para el ajuste fino de modelos LLM y la IA generativa. El H200, por otro lado, incorpora memoria HBM3e, lo que lo hace adecuado para entrenar modelos grandes con cargas de trabajo de IA más exigentes. El B200, por su parte, es caro y está diseñado para ofrecer la máxima eficiencia. Si el presupuesto lo permite, opte por el B200 para cargas de trabajo de vanguardia, el H200 para un entrenamiento equilibrado con uso intensivo de memoria, y si dispone de menos recursos, el H100 es la mejor opción.
¿Cuánta memoria de GPU necesito para los LLM modernos y la IA generativa?
Los LLM pequeños y medianos pueden ejecutarse eficientemente en GPU con entre 40 y 80 GB de VRAM. Para LLM más grandes, se necesitarán entre 80 y 120 GB por GPU, a menudo en configuraciones multiGPU. El entrenamiento o el ajuste de modelos a escala GPT requieren GPU como H200 o B200 con más de 140 GB de memoria HBM3e por unidad.
¿Debería comprar servidores GPU locales o utilizar proveedores de GPU en la nube en 2026?
¡Sí! Los servidores GPU locales son perfectos para organizaciones con capacitación continua y cargas de trabajo intensas. Ofrecen control total sobre el hardware y la seguridad de los datos. Los proveedores de GPU en la nube (AWS, Azure, Google Cloud) ofrecen las GPU más recientes, como H200 y B200.
¿Qué otros componentes del servidor son importantes además de la GPU?
Se necesitan CPU de alto núcleo (como AMD EPYC e Intel Xeon) para alimentar datos a las GPU de forma eficiente. La RAM de alto ancho de banda (DDR5) reduce los problemas de preprocesamiento. El almacenamiento SSD NVMe es importante para gestionar conjuntos de datos masivos de IA a alta velocidad. Finalmente, la refrigeración y la alimentación también son cruciales.
¿Qué marcas de GPU son mejores para el aprendizaje profundo: NVIDIA o AMD?
Las GPU NVIDIA son las mejores para el aprendizaje profundo gracias a su ecosistema CUDA. Frameworks como PyTorch y TensorFlow están altamente optimizados para el hardware NVIDIA, lo que lo convierte en la mejor opción para la mayoría de los proyectos de IA. AMD, por otro lado, también ofrece un rendimiento excepcional.
Conclusión
El uso del Servidor GPU para IA y aprendizaje automático Puede transformar por completo la forma de gestionar grandes cantidades de datos y tareas complejas. En lugar de esperar días o incluso semanas para entrenar un modelo, la GPU obtiene resultados mucho más rápido y con mayor precisión. Ahorra tiempo y facilita la experimentación con diferentes modelos de IA, mejorando así la eficiencia.
Todos los proveedores de servidores GPU que hemos mencionado en este blog Todos los productos han sido sometidos a pruebas exhaustivas y a una revisión minuciosa, lo que garantiza la fiabilidad de la información que aquí se presenta. Cada uno tiene sus características únicas y la elección correcta depende del tipo de trabajo que se planea realizar.
Supongamos que tu tarea se centra en el reconocimiento de imágenes o el aprendizaje profundo; en ese caso, podrías necesitar una GPU de gama alta, mientras que las tareas sencillas de aprendizaje automático no requerirían tanta potencia. Por eso es importante elegir un servidor GPU en función de las necesidades específicas de tu proyecto.
¡Con el servidor adecuado, usted podrá centrarse menos en cuestiones técnicas y más en crear soluciones!
¿Busca otros planes de servidor? Aquí tienes-
- Mejor alojamiento de servidor Valheim
- El mejor alojamiento de servidor Rust
- El mejor alojamiento de servidor ARK
- El mejor servidor de alojamiento cubierto
- El mejor alojamiento de servidor Palworld
- El mejor alojamiento de servidor satisfactorio
- El mejor servidor de ARK Survival Ascended
- El mejor alojamiento de servidores Hytale
- El mejor alojamiento de servidor V Rising
- Cómo alojar un servidor dedicado de Project Zomboid


Índice
- ¿Qué es un servidor GPU para IA y aprendizaje automático?
- Los 7 mejores servidores GPU para IA y aprendizaje automático en 2026
- 1. InterServer - El mejor servidor GPU en general para IA y aprendizaje automático
- 2. LiquidWeb: el mejor servidor GPU para IA y aprendizaje automático
- 3. DigitalOcean: servidores GPU escalables para IA y aprendizaje automático
- 4. Vultr: Servidores GPU asequibles para IA y aprendizaje automático
- 5. E2E Cloud: los principales servidores GPU de la India para IA y aprendizaje automático
- 6. Amazon Web Services: servidores GPU de nivel empresarial para la innovación en IA
- 7. Google Cloud Platform: servidores GPU de alto rendimiento para IA y aprendizaje automático
- ¿Por qué elegir GPU Server para IA y aprendizaje profundo?
- Factores a considerar al elegir una GPU para aprendizaje profundo
- FAQ’s
- Conclusión